#020 — RAG: модель не мусить пам'ятати, вона мусить знайти
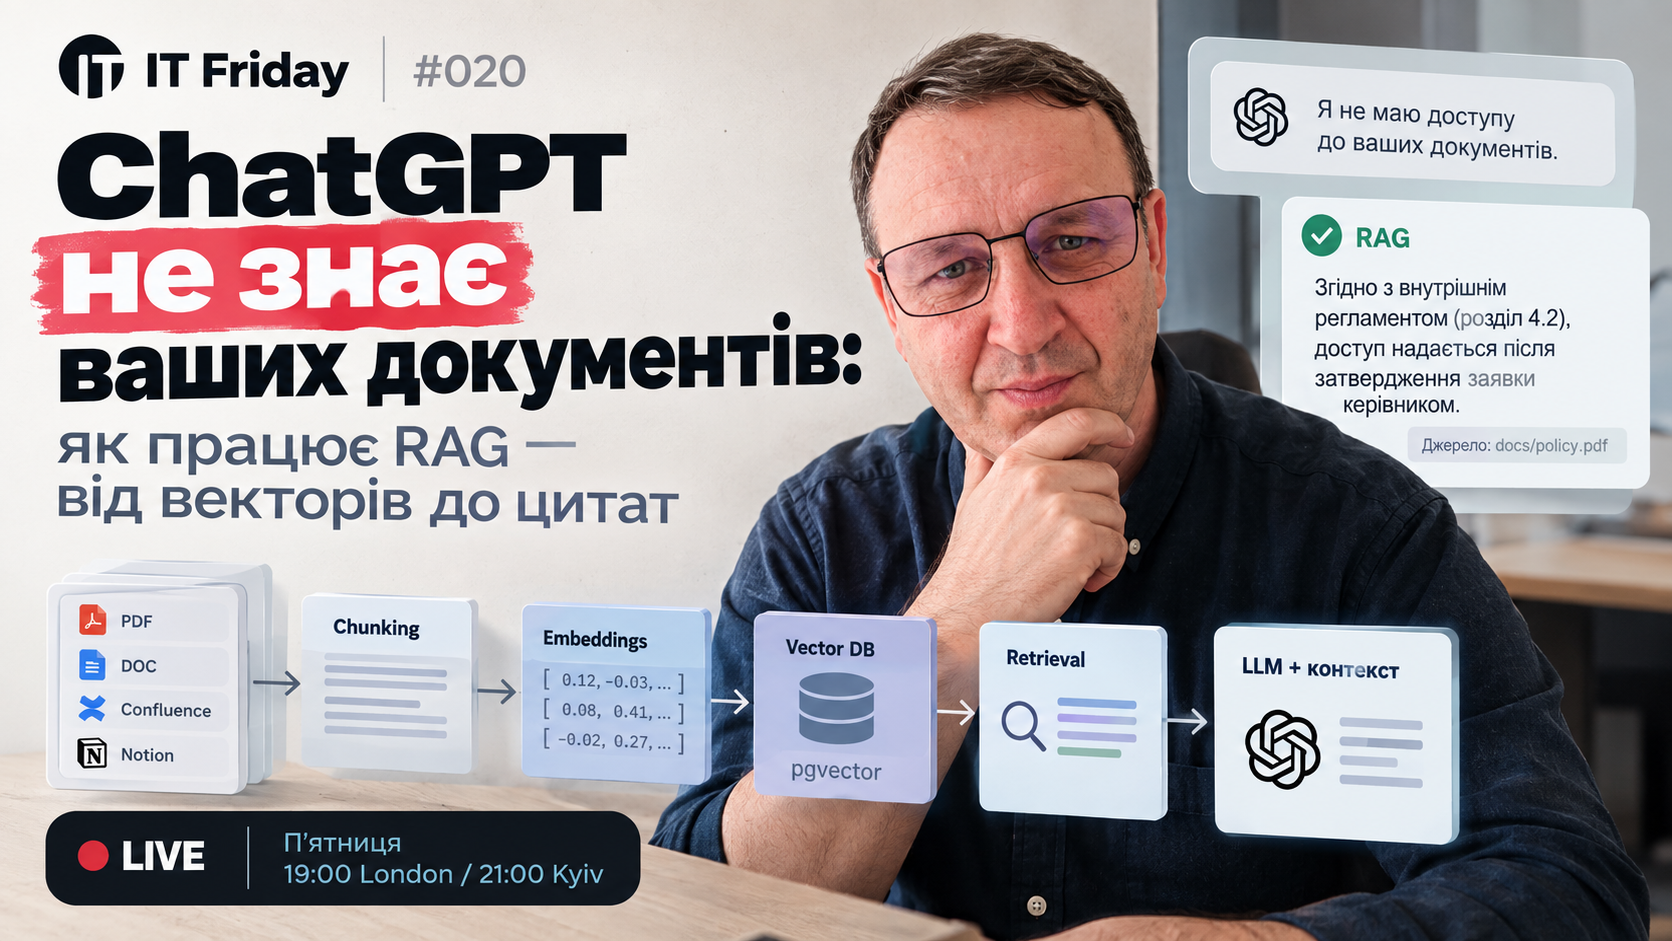
Дата: 25 вересня 2026 | 19:00 London / 21:00 Kyiv
Формат: Гостьова доповідь · технічний deep-dive · ~60–70 хвилин
Гість: Олександр Блажейко
YouTube: https://youtube.com/live/ZIyIUK7vGQU
Учасники
Олександр Блажейко — Software Development Engineer · Fullstack
Україна
LinkedIn · itvibe.party
Про що поговоримо
LLM знає світ станом на дату навчання — і нічого не знає про ваші документи, регламенти й тікети. RAG не змінює модель: він щоразу знаходить потрібний фрагмент і підкладає його перед відповіддю. Олександр Блажейко розбирає, як це працює всередині і чому якість RAG визначає пошук, а не модель.
Що розберемо
- Навіщо RAG: fine-tuning vs довгий контекст vs RAG — що дає і скільки коштує кожен підхід
- Архітектура: дві фази — індексація і запит
- Вектор як сенс тексту: embeddings і косинусна схожість на пальцях
- Метрики близькості і pgvector: який оператор брати і чому індекс може мовчки не працювати
- Векторна база: що зберігається, метадані, як HNSW знаходить сусідів
- Чанкінг: розмір, перекриття, small-to-big
- Гібридний пошук (вектори + BM25), реранкер і переписування запиту
- Промпт із цитуванням і дозволом сказати «не знаю»
- Як міряти якість: Recall@k, Faithfulness, golden dataset
- Типові граблі — і коли RAG взагалі не потрібен
Ключові тези
Будуть додані після стріму.
Таймкоди
Будуть додані після стріму.
Ресурси
- Слайди — RAG: модель не мусить пам'ятати, вона мусить знайти (Олександр Блажейко)
- Lewis et al., 2020 — Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
- pgvector — векторний пошук у PostgreSQL
- RAGAS — оцінка якості RAG-систем
- itvibe.party — проєкт Олександра Блажейка
- LinkedIn-сторінка
- Telegram-ком'юніті
- Discord-сервер